GPU運用負荷
リソース調達・配置・稼働管理の負荷が高く、継続運用のボトルネックになりやすい。


閉域AI駆動開発
保守基盤提供サービス
AI Operations Foundation for Production Use
PoC後のAI活用を実運用へつなげるために、GPUクラスター運用、モデルサービング基盤、監視・可観測性、保守サポート、アップデートパイプラインを組み合わせて提供します。閉域環境の安全性を保ちながら、AI基盤の安定稼働と継続的な価値向上を支援します。
リソース調達・配置・稼働管理の負荷が高く、継続運用のボトルネックになりやすい。
環境構築、バージョン管理、依存関係の維持が大きな負担になる。
専門人材の確保が難しく、障害対応や改善活動が属人化しやすい。
PoC止まりで本番移行後の継続運用に不安が残り、ビジネス成果につながりにくい。
本番AIの安定稼働に必要なGPUクラスター運用、モデルサービング基盤、監視・可観測性を組み合わせて提供します。
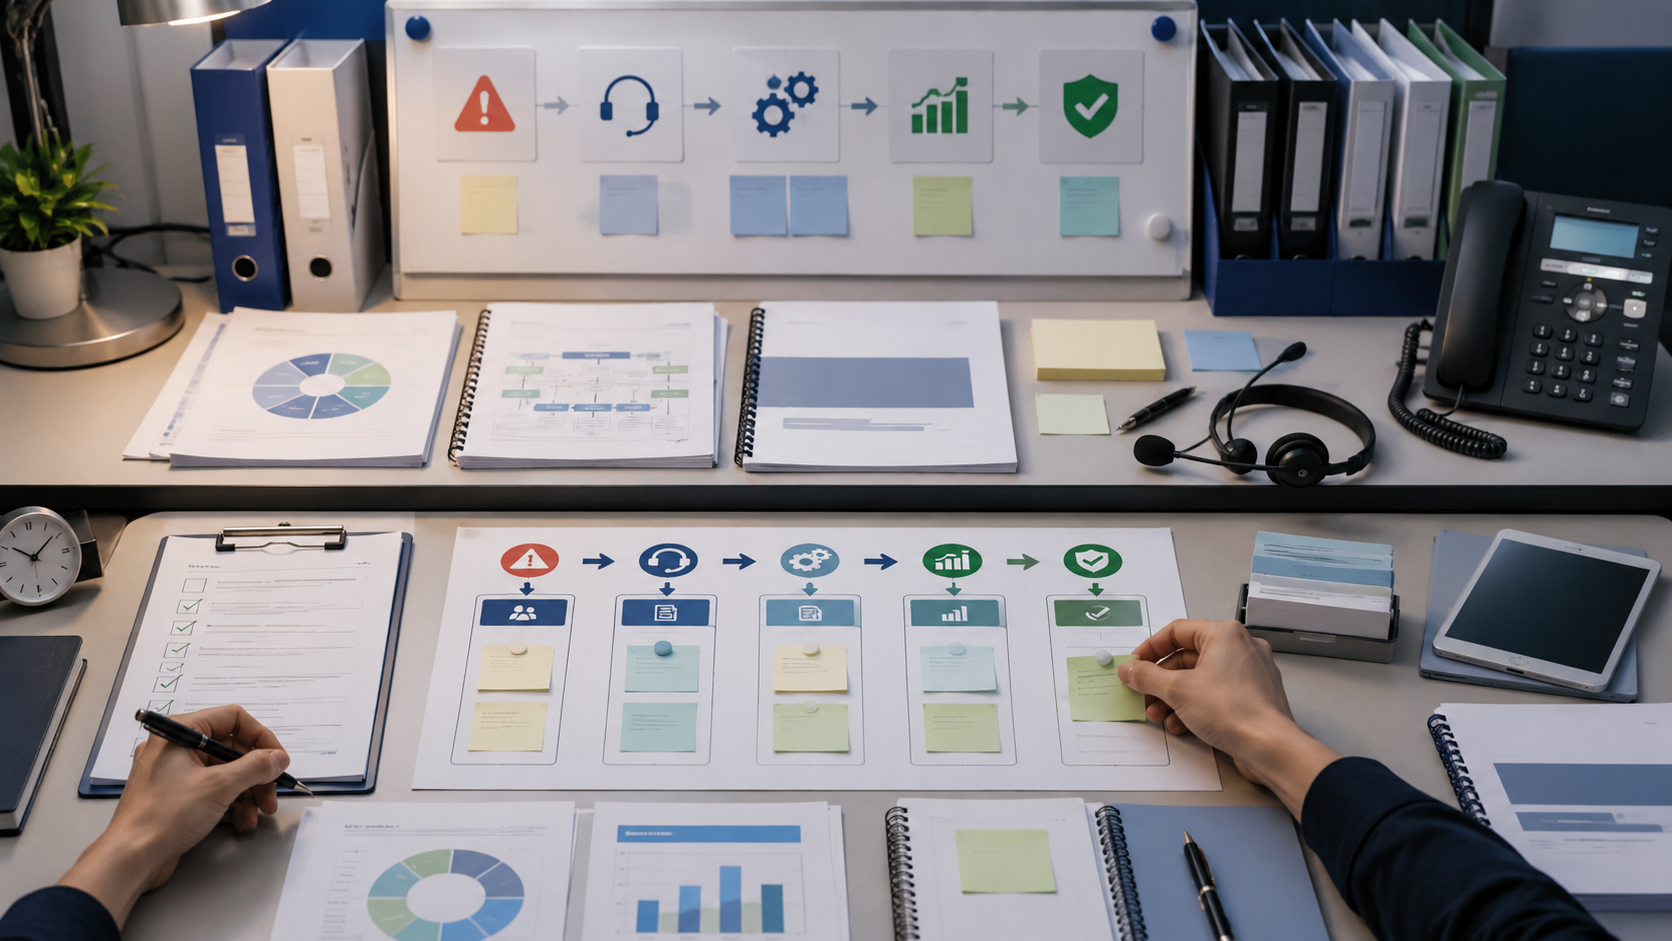
専門チームが障害対応、問い合わせ、改善活動を支援し、AI基盤の運用を属人化させずに継続できる体制づくりを支えます。
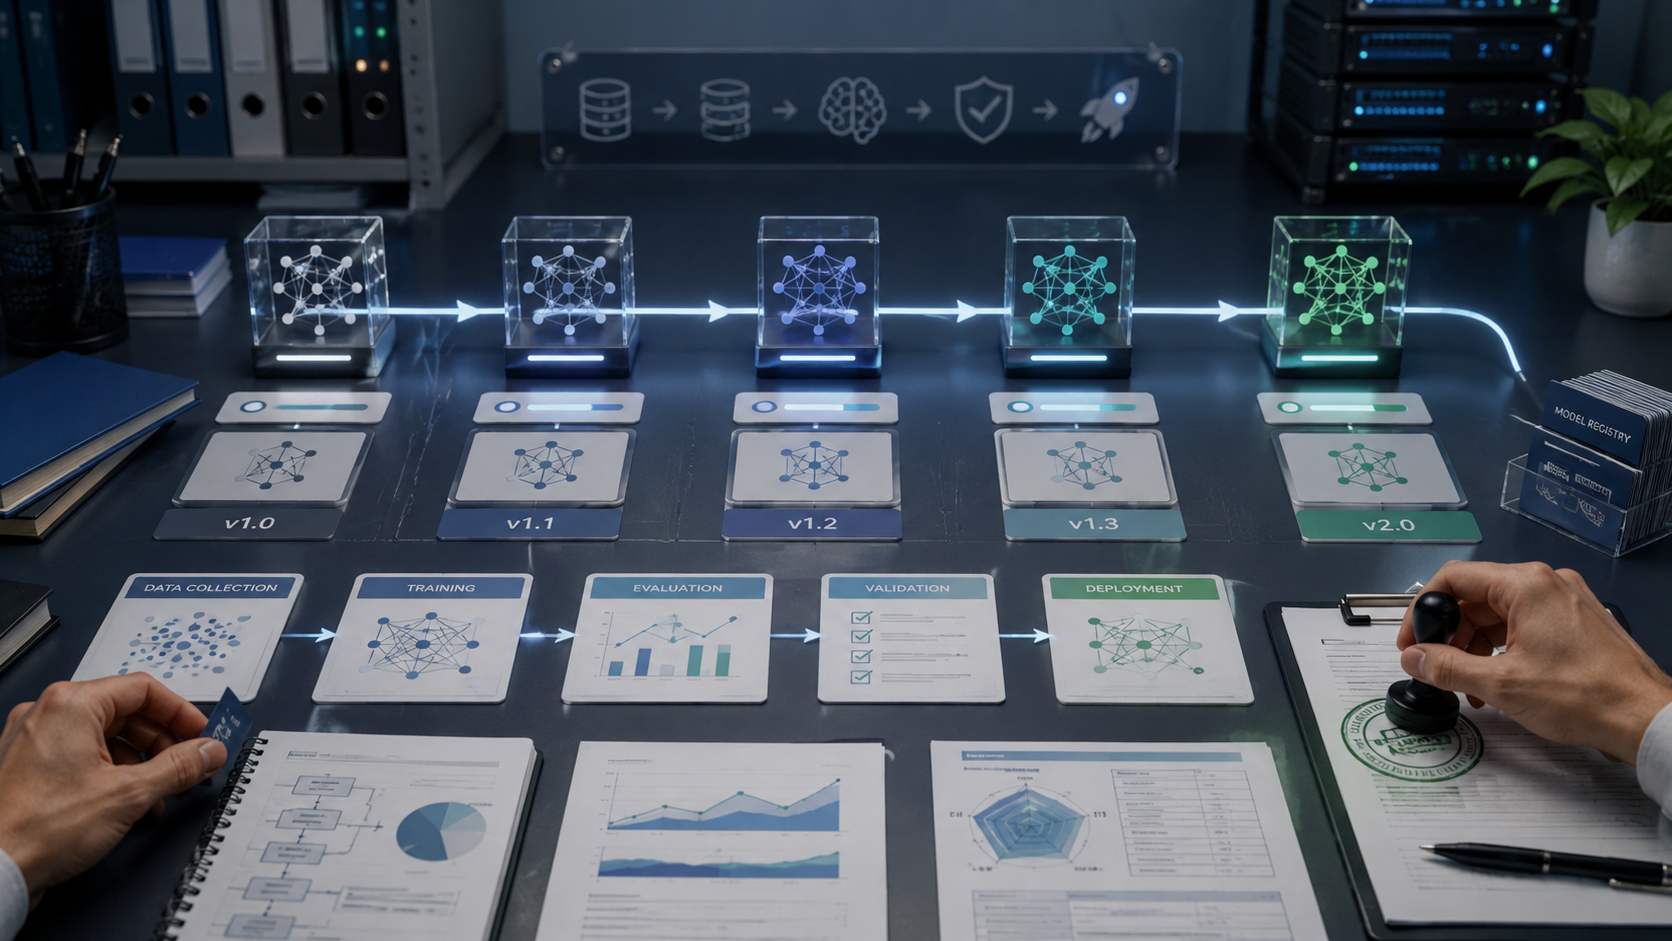
モデル改善、再学習、バージョン管理、ライブラリやセキュリティ更新を計画的に適用し、AIの精度と価値を継続的に高めます。
閉域環境の安全性を前提に、脆弱性管理、アクセス制御、コンプライアンス対応を行い、安心して長く使えるAI基盤を維持します。
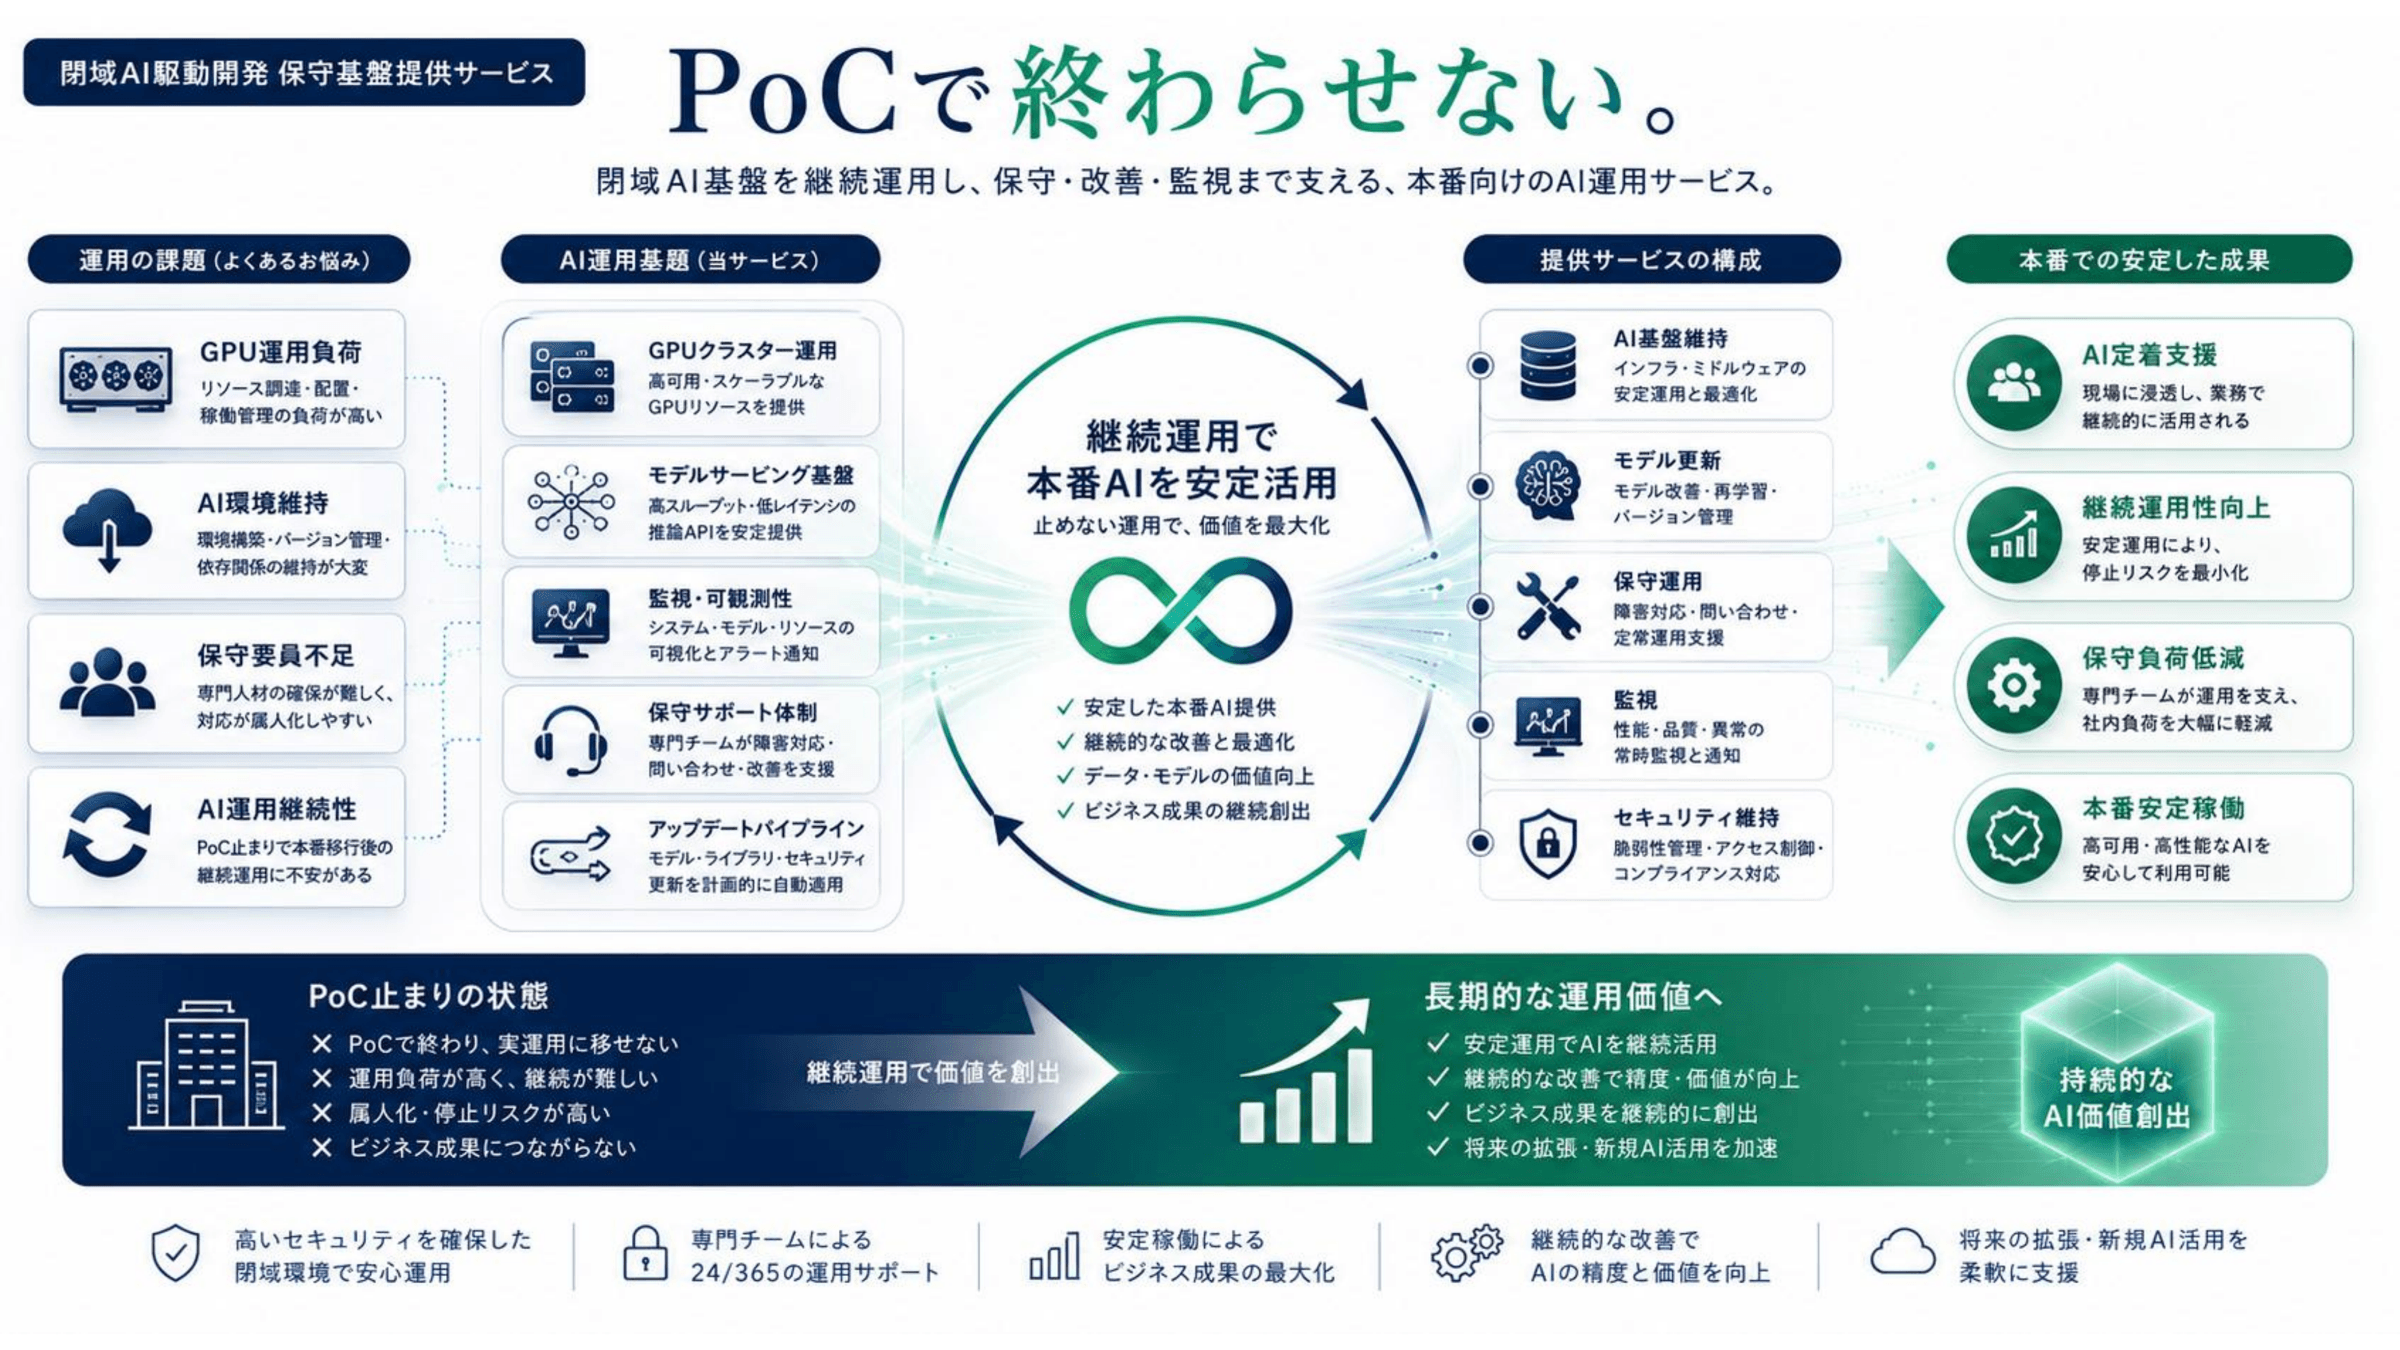
現場に浸透し、業務で継続的に活用される状態を支援します。
安定運用により、停止リスクを最小化します。
専門チームが運用を支え、社内負荷を大幅に軽減します。
高可用・高性能なAIを安心して利用できます。
対象業務、AI基盤の構成、セキュリティ要件、監視レベル、保守体制に合わせて、閉域AI基盤の運用設計をご提案します。PoC後の本番運用や既存基盤の保守強化についてもご相談ください。